传统数据中心过去主要用于数据的存储、检索与处理。但在生成式AI与代理式AI时代,这些设施已演变为AI Token工厂。随着AI推理成为其核心工作负载,它们的主要产出已转变为以Token形式制造的智能。
这一转变也需要对包括总体拥有成本(TCO)在内的AI基础设施的经济效益评估的方式相应地进行调整。然而,在评估AI基础设施时,企业仍过于关注芯片峰值规格、计算成本,或每美元所能获得的浮点运算性能,即每美元FLOPS。
关键区别在于:
•算力成本是企业为AI基础设施所支付的费用,无论是从云服务提供商租用,还是在本地自建部署。 •每美元FLOPS衡量的是企业每投入一美元所获得的原始算力,但原始算力并不等同于现实世界中的Token产出。 •每Token成本指的是企业生成并交付每一个Token的综合成本,通常以每百万Token成本来表示。
前两者仅是投入指标。但当业务围绕产出运转时,只针对投入优化,本质上是一种根本性的错配。
每Token成本决定了企业能否实现AI的规模化盈利。它是唯一能够直接综合反映硬件性能、软件优化、生态系统支持以及实际利用率的TCO指标,而NVIDIA在这一指标上实现了行业最低的每Token成本。
能够降低每Token成本的因素有哪些?
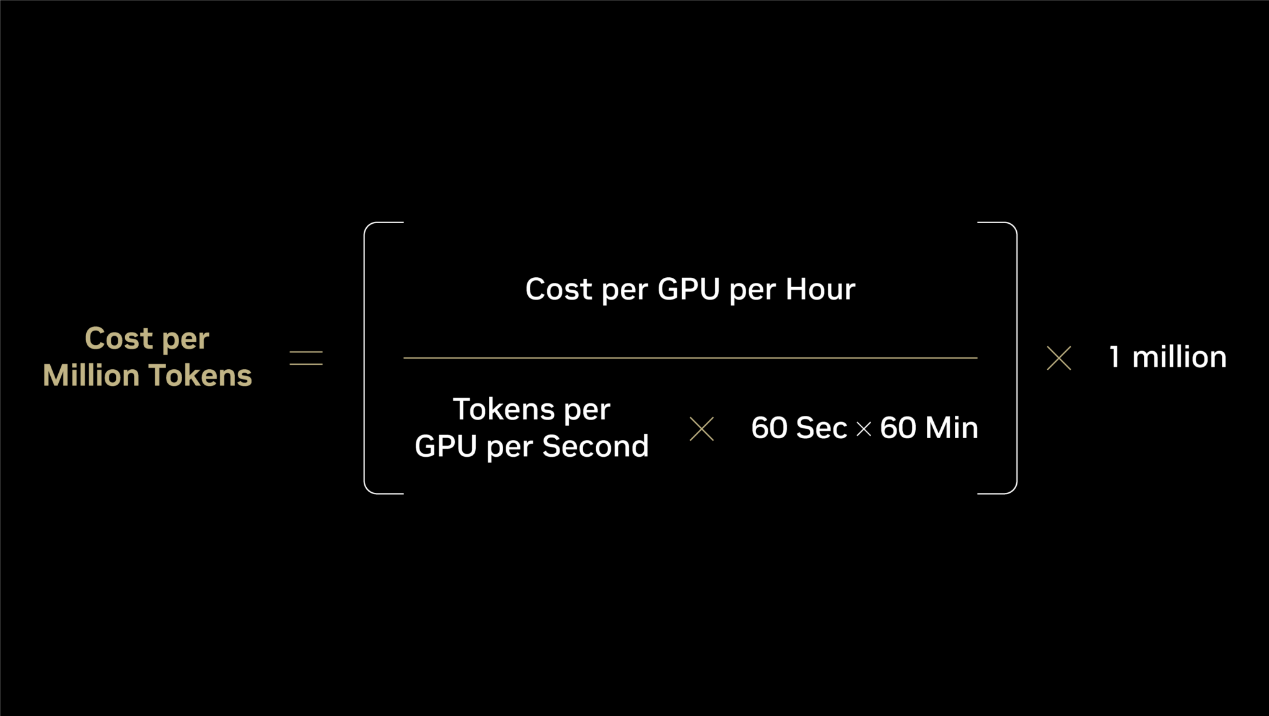
要理解如何优化每Token成本,首先需要了解用于计算“每百万Token成本”的计算公式。
在这个公式中,许多评估AI基础设施的企业往往只关注分子项,即每GPU每小时成本。对于云部署而言,这对应支付给云服务提供商的小时费用;而对于本地部署,则是通过摊销自有基础设施得到的等效小时成本。然而,降低每Token成本的关键在于分母,即最大化实际交付的Token产出。
这个分母传递了两层商业含义:
•最小化每Token成本:当Token产出增加被代入公式时,将降低每Token成本,从而提升每一次交互服务的利润空间。 •最大化收入:每秒交付更多Token,也意味着每兆瓦产出更多的Token,这将带来更高的智能供给能力,使AI驱动的产品与服务能够在相同基础设施投入下创造更高收入。
因此,如果只关注分子,就会忽视真正决定分母的因素。可以将其理解为一个“推理冰山”:分子位于水面之上,直观可见且易于横向比较;而分母则隐藏在水面之下,那才是决定实际Token产出的关键因素。对AI基础设施的准确评估,应从探究水面之下的部分开始。
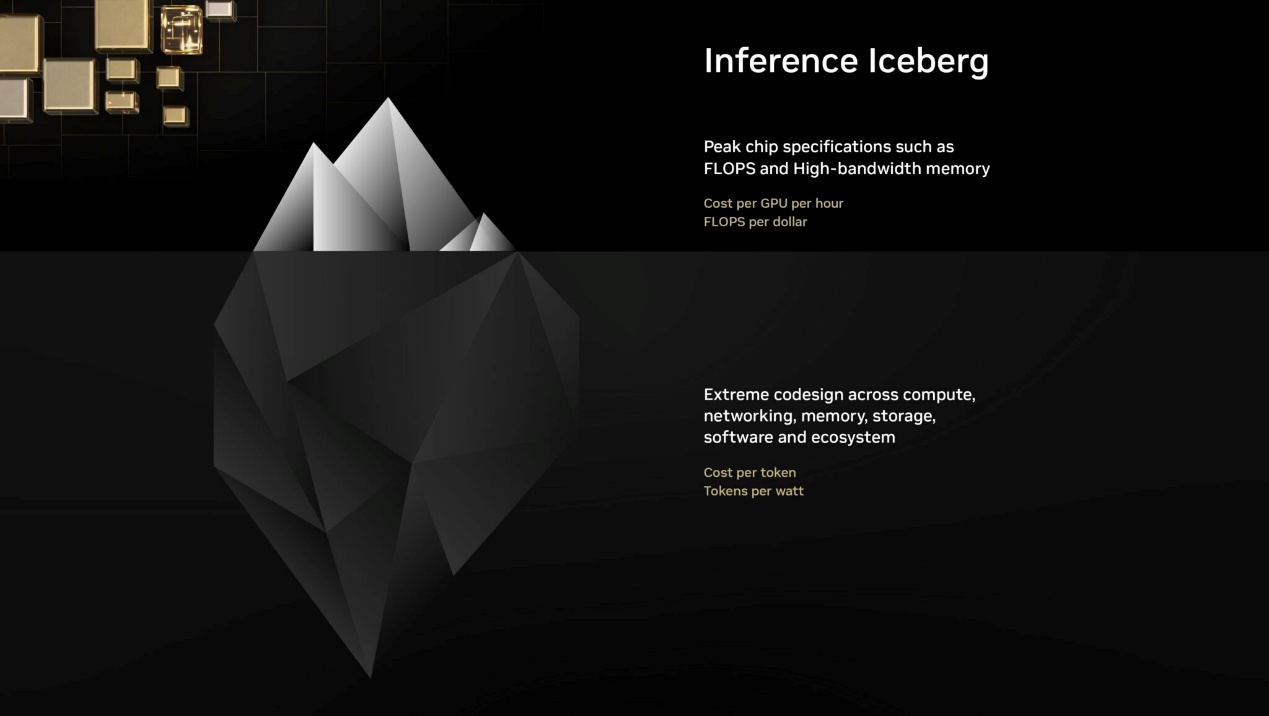
•深度成本分析: ○每百万Token的成本是多少?尤其是针对大规模混合专家(MoE)推理模型(当前部署最广泛的一类AI模型),其每百万Token成本是多少? ○每兆瓦可交付多少Token产出?尤其是对本地部署而言,由于在土地、电力与基础设施上的资本投入较大,最大化每兆瓦所产生的智能产出至关重要。 ○纵向扩展(scale-up)互连是否能够支撑MoE模型所需的“all-to-all”通信模式? ○是否支持FP4精度?推理栈是否能够在保持高精度的同时充分利用FP4? ○推理运行时是否支持投机解码或多Token预测,以提升用户交互体验? ○服务层是否支持解耦服务、KV感知路由、KV缓存卸载以及其他优化? ○平台是否支持代理式AI的独特工作负载需求,包括超低延迟、高吞吐以及长输入序列长度等? ○平台是否支持从训练、后训练到大规模推理的完整生命周期,并覆盖所有模型架构,从而实现基础设施可互换性与高利用率?
这些算法、硬件与软件化中的每一项优化都必须有效并且是可以相互集成的,否则分母项将无法成立。一块看似“更便宜”的GPU,如果其每秒Token产出数量明显更低,反而会导致更高的每Token成本。能够做到全栈真正优化的AI基础设施,才能够确保每项优化都相互增强,从而持续提升整体效率。
为什么每Token成本比每美元FLOPS更重要?
以下DeepSeek-R1 AI模型的数据展示了理论指标与实际商业结果之间的差异。
仅从算力成本来看,NVIDIA Blackwell平台的成本似乎约为NVIDIA Hopper的2倍,但算力成本并不能说明这项投入究竟能带来多少实际产出。如果仅以每美元FLOPS进行分析,相较于NVIDIA Hopper架构,NVIDIA Blackwell仅有约2倍优势。然而,实际结果却呈现出数量级差异:Blackwell每瓦的Token产出量是Hopper的50倍以上,每百万Token的成本降低至其1/35左右。
|
指标 |
NVIDIA Hopper(HGX H200) |
NVIDIA Blackwell(GB300 NVL72) |
Blackwell相较Hopper |
|
GPU每小时成本(美元) |
$1.41 |
$2.65 |
2x |
|
每美元FLOPS(PFLOPS) |
2.8 |
5.6 |
2x |
|
每GPU每秒Token产出 |
90 |
6,000 |
65x |
|
每兆瓦Token产出 |
54K |
2.8M |
50x |
|
每百万Token成本(美元) |
$4.20 |
$0.12 |
降为1/35 |
注:数据来源于NVIDIA分析报道及SemiAnalysis InferenceX v2基准测试。
这一悬殊差异表明,相较于上一代Hopper,NVIDIA Blackwell在商业价值上实现了巨大的跃迁,其提升幅度远超系统成本的增加。
如何选择合适的AI基础设施?
仅凭算力成本或每美元理论FLOPS来比较AI基础设施,不仅是不充分的,也无法真实反映推理经济学。正如数据所展示的,要准确评估AI基础设施的营收潜力与盈利能力,需将衡量维度从输入指标转向每Token成本和实际Token产出量。
NVIDIA通过在计算、网络、内存、存储、软件以及合作伙伴技术上的极致协同设计,实现了业内最低的Token成本与最高的Token吞吐量。此外,诸如vLLM、SGLang、NVIDIATensorRT-LLM以及NVIDIA Dynamo等基于NVIDIA平台构建的开源推理软件的持续优化,意味着在现有NVIDIA基础设施部署后,Token产出仍可不断提升,每Token成本会持续下降。
领先的云服务提供商与NVIDIA云合作伙伴,已在规模化部署中充分体现这一优势。包括CoreWeave、Nebius、Nscale与Together AI在内的合作伙伴,已部署NVIDIA Blackwell基础设施,并对其技术栈进行了优化,为企业提供当前最低的Token成本,同时充分发挥NVIDIA在硬件、软件与生态系统协同设计方面的全部优势,使每一次AI交互的处理都建立在这一完整体系之上。
来源:飞象网

相关推荐
-
AI手机走向个人智能 让AI离你更近
AI手机竞争的下半场,比的不再只是模型,而是系统有多懂你。这个9月,手机圈的新品大战还在继续,操作系统却悄悄成了主角。荣耀发布行业首个真正实现系统级Agent Harness商用落地的MagicOS 11;vivo推出主打“个人化智能”的原系统7;OPPO的ColorOS 17,把“主动智能”写进了系统基因。三场发布会,一个共同信号:AI手机的竞争,正在从大模型能力、系统级应用,进一步向“个人智能”延伸。
-
OPPO创始人陈明永发声:谈本分、AI与OPPO的未来
近日,OPPO迎来31周年司庆。OPPO创始人、CEO陈明永在内部公开谈话,分享了对公司文化、AI变革以及未来发展的最新思考。
-
360纳米Work启动“双城千店上岗计划” 探索实体商业AI落地新路径
9月17日,2026北京艺术与科技周在北京798艺术区开幕。360集团创始人周鸿祎参加开幕式,并宣布360旗下AI办公平台纳米Work正式启动“双城千店上岗计划”。作为本届活动独家AI合作伙伴与官方办公支持平台,纳米Work将以798为首站推进场景合作;10月也将以同一身份参与第11
-
长飞构建AI光互连全链生态:高速畅、换乘快、规划好
AI大模型正以惊人的速度迭代,在思维与推理能力上不断突破,参数量迈向万亿乃至十万亿规模。全球科技巨头持续加大对AI基础设施的投入,力争抢占人工智能技术高地。其背后是作为承载大模型训练与推理任务的智算中心在算力与运力上协同发力,从而形成更大更高效的算力集群规模,构建最强AI大脑。
-
易鑫首次跻身IDC全球金融科技Top 50,AI实力获国际权威认可
近日,国际咨询机构IDC正式发布2026年度全球金融科技系列榜单(IDC FinTech Rankings 2026)。凭借持续深化的科技创新及在汽车金融领域的AI规模化落地应用实绩,易鑫(02858. HK)成功跻身全球金融科技Top 50梯队,并入选新兴金融科技(Emerging FinTech)榜单,这是易
-
华为汪涛:契合AI算力集群化发展需要 3D数据中心是新一代AIDC优秀实践
9月15日,在2026 AIDC产业发展大会暨3D数据中心现场会在安徽芜湖隆重举行。华为技术有限公司副董事长、轮值董事长汪涛出席并致辞,分享了华为在人工智能与AI基础设施上的战略思考。
-
四大数据处理AI测评,AI做表能力封神!
月末关账,VLOOKUP 在十万行里反复报 #N/A;运营做活动复盘,SUMIF 条件区域选错导致 GMV 统计偏差;销售管客户表,手工去重、补全、格式统一耗掉整个下午——这些场景不分行业,几乎每天都在上演。更让人头大的是,市面上的AI数据处理工具越来越多,个个都说自己最懂数
-
2026年AI隐私保护手机怎么挑,端侧处理更值得关注
AI功能越来越多以后,用户的关注点也在变化。以前问的是“AI能做什么”,现在更常问“我的通话、视频和个人信息到底在哪里处理,会不会被上传”。手机里存着聊天记录、证件照片、订单信息和账号资料,AI助手在帮忙记录和提醒的同时,数据流向是否清晰、敏感内容如何存储
-
循表探里,通往AI原生6G未来:高通与联通让智能路路通达
当AI开始成为离不开的伙伴,当6G开始向世人揭开面纱,当2026成为智能体元年,运营商的下一步怎么走,成为很多人讨论的话题。值得一提的是,不久前高通公司工程技术高级副总裁马德嘉曾专门在6G技术日期间提到了中国运营商正发生的角色演进:不仅承载流量,还将开始承载智能。
-
向智同行 连接算力新生态,2026中国联通合作伙伴大会集中展示AI创新成果
9月9日,2026中国联通合作伙伴大会展览在上海世博中心举办。展览以“向智同行 连接算力新生态”为主题,聚焦“连接”“算力”“服务”“安全”四大核心赛道,集中展示中国联通AI创新成果和数字技术融合创新实践。