都说机器人缺数据,缺的到底是什么?
飞象原创(高靖宇/文)世界模型,已经成为今年AI行业最热闹的赛道之一。AMD宣布以约82亿美元收购李飞飞创办的World Labs,谷歌发布新一代世界模型Genie 4,百度Apollo World世界模型亮相――巨头们接连出手,一场通往物理AI的竞赛就此开启。
为什么世界模型突然成了焦点?行业里一个普遍的共识是:语言模型可以描述世界,而世界模型则是让AI理解现实世界的运行规律。理解了规律,AI才有可能真正走出屏幕、作用于物理空间。
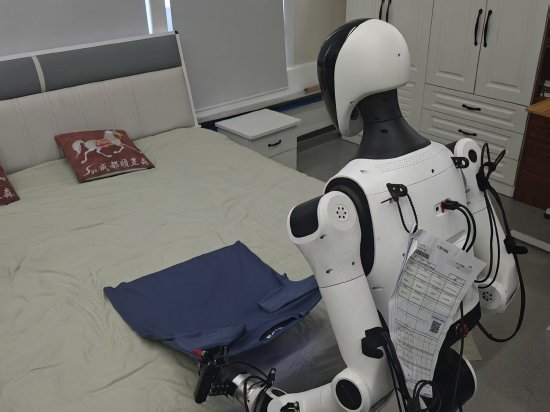
当机器人走进仓库,面对一件从未见过的商品,伸手去取,却常抓空、碰倒、卡住。它缺的不是力气,而是对世界的“预判”――物体多重、如何滑动、碰撞后怎样反应,这正是世界模型要教会它的。但要练成这种预判,得先给它喂饱真实世界数据,而数据的紧缺,正在阻碍具身智能快速、规模化地进入现实世界。
数据荒,荒的不是量
2026年7月,李飞飞在a16z播客上说了一段后来被反复引用的话:机器人面临一个极其困难的问题,就是非常缺乏数据,无论是训练数据还是评估数据都严重不足。大语言模型只需要理解语义,但机器人必须理解物理世界“这些信息不是看到就能获取的,必须通过真实世界的物理交互才能采集。”
这句话点破了数据荒的本质。互联网上的文字、图片、视频管够,但那是“世界长什么样”的数据;机器人要的是“从这个角度、用这个力度捏下去会发生什么”的物理后果数据。前者免费,取之不尽,后者要在真实物理世界里一小时一小时地采。
真值数据采集的另一层困境是不通用。李飞飞提到,不同型号的机器人、不同的工作场景、不同的光照和物体条件,采集到的数据几乎不能互相迁移――一台机器人在A工厂学会的抓取,换到B工厂的产线上就要重新训练。
仅把大模型塞进机器人,产生不了真正的具身智能。
大模型需要怎么“投喂”?
面对这道难题,李飞飞给出的解法是Real-to-Sim-to-Real:在真实世界采集数据,构建高保真仿真环境,在仿真中大规模训练策略,再把模型部署回真实世界。
她创办的World Labs在2026年动作频频:收购仿真厂商SceniX,9月发布多模态世界模型Atlas,重心明显落在“Sim”这一环――用生成式模型批量造数据。
这当然是对的。但链条的第一环Real――用什么眼睛去真实世界里采――在行业叙事里被严重低估。喂进仿真的真实数据,如果本身是脏的、有视差的、有时差的、在玻璃和金属表面是空洞的,那么Sim-to-Real的鸿沟只会越填越宽。
为什么是现在这个节点暴露问题?因为VLA模型把视觉输入的瓶颈放大了。Google的RT-2、Physical Intelligence的π0,这些端到端模型把视觉、语言、动作焊在一起。模型越强,对输入端数据质量越敏感――稀疏的、有延迟的、有对齐误差的点云,会让再强的模型也只能在“失真世界”里做推理。
用“眼睛”还原真世界
如何让机器人“看得清”“看得准”?目前,主流厂商习惯用“组合拳”,远距离,交给激光雷达类传感器。以dToF为核心,配合CMOS与IMU,主打长距建图与定位导航。主流产品最远测距70米,稳定精度达厘米级,机器人靠它做全局避障;近距离,交给高精度深度相机。以散斑结构光或iToF与IMU一体化集成,专注机械臂末端的高精度操作。在8米范围内实现±5mm的稳定感知,机器人靠它“看”清细节。
这是工程上最成熟的组合拳,但从原理上绕不开三个死穴:
视差。多个传感器物理位置不同,看到的角度不同,后端融合必有对齐误差。
时差。深度相机约10Hz,激光雷达约15Hz,RGB相机20到30Hz。帧频、时间戳、空间定位都不一样;对高速运动物体,这个差就是失控的距离。
材质盲区。高反光金属、透明玻璃、亮面薄膜,光要么穿透要么镜面反射,传统算法拿到的点云是残缺的,甚至完全空白。
这三个问题不是算法不够好,是“先成像、后计算”这条路线自带的物理缺陷,装得越多,割裂越深,模型需要花大量成本去做对齐、做融合,行业需要找到更优解。
一颗传感器打开“智慧之眼”
今年8月,由中国工程物理研究院、清华大学共同创立的杭州时空张量机器人从真实世界出发,推出自研7D空间张量传感器“天眼・Tensopt”,用先计算、后成像的底层架构,从物理层面终结了多传感器的能力短板。
所谓7D,是把计算机视觉里全光函数的七个维度――XYZ三维坐标、RGB外观语义、时间戳――融进一枚传感器、一条光路,直接输出实时彩色点云。这意味着“天眼”仅依靠单颗传感器,就能在物理底层实现对多传感器的融合。落到硬指标上,“天眼”实现了对现有行业方案的全面领先:感知距离覆盖0.15m至30m,距离精度小于1%(达毫米级±3mm),点云输出密度高达3072万点/秒,是主流方案的3倍以上,三维成像帧频达25Hz(全分辨率),无运动畸变。
场景比参数更有说服力。机器人进厨房洗碗,玻璃杯、保鲜膜、不锈钢锅是传统视觉的盲区。天眼可直接测量空间光场的占用率,对透明玻璃、高反光金属实现无空洞重建;天眼以毫米级精度和稠密点云支撑机械臂“最后一毫米”的手眼协同;天眼可支持特种机器人在强光、眩光、逆光环境下稳定工作,源于“天眼”抗干扰能力达100K Lux,不受环境光变化干扰,机器人看到的不是“过曝的白片”,而是清晰的真实世界。
有了“天眼”,机器人也就摆脱了“看不清”“看不准”的尴尬,在真实场景中行走、抓取、交互将更加游刃有余。
结语:
世界模型的竞赛,最终要在真实世界里兑现。当巨头们在算力与参数上短兵相接,一个更底层的变量正在浮出水面――数据荒的解法,或许不在算法,而在传感器;物理AI的比拼,或许比的是谁先让机器“看懂”真实世界。这条路还很长,但方向已经清晰。
来源:飞象网

相关推荐
-
T-Mobile正在测试人形机器人通过边缘运行AI
T-Mobile US 首席技术官(CTO)John Saw 透露,公司正在测试人形机器人是否可以通过在其网络边缘(Network Edge)运行部分人工智能(AI),从而提高响应速度并减少对机载计算机的依赖。Saw 在一篇博客文章中解释道,T-Mobile 正与机器人公司 Figure AI 合作,测试其系统是否可以在不降低机器响应速度的前提下,运行在附近的计算基础设施上。
-
工信部公示农业领域机器人典型应用场景名单
飞象网讯(致新/文)10月16日消息,工信部近日发文称,根据《工业和信息化部办公厅 农业农村部办公厅关于开展农业领域机器人典型应用场景遴选工作的通知》(工信厅联通装函〔2026〕269号),现将拟入选的农业领域机器人典型应用场景进行公示,请社会各界监督。如有异议,请在公示期内将书面意见反馈至工业和信息化部装备工业一司(智能制造处)。公示时间:2026年10月15日至2026年10月21日。
-
DeepSeek拟领投前腾讯科学家创办的机器人AI初创公司 估值约4亿美元
DeepSeek计划领投一家成立仅数月、致力于开发机器人AI的初创公司的首轮融资,动用其自身逾120亿美元融资所得资金,押注科技行业增长最快的领域之一。
-
聚焦世界模型与数字孪生,2026中国元宇宙大会在沪举办
10月11日,CMC2026第四届中国元宇宙大会在上海张江科学会堂开幕。本届元宇宙大会由中国人工智能学会主办,以“虚实无界,智创未来”为主题,聚焦世界模型与数字孪生,探讨通过人工智能来赋能元宇宙技术的发展,并在现场发布《中国人工智能系列白皮书――元宇宙技术(2026版)》。
-
“物理AI”再迭代:量化派用机器人完成“清炒土豆丝”11步实景测试 解锁中式热炒技术新维度
物理AI与具身智能产业迭代持续推进,行业发展重心逐步从模型参数比拼、实验室场景演示,转向真实物理环境适配、复杂工况调试与连续作业能力打磨。政策层面,8月26日国新办开局起步'十五五'系列发布会上,工信部将世界模型列为人工智能前沿技术攻关方向,提出坚
-
宇树突破技术瓶颈,首次实现人形机器人全自主格斗实时驱动
9月7日晚间消息,宇树科技(536.350, 6.05, 1.14%)发布全球首次世界模型实时驱动全自主人形机器人(14.370, 0.09, 0.63%)格斗视频。
-
北京人形数据基地下载量破2000万,基地负责人夏华林:未来具身智能最核心的竞争点是数据飞轮
9月3日晚间消息,今日,北京人形机器人(14.360, 0.09, 0.63%)创新中心具身智能数据与训练基地开放。基地负责人夏华林交流时表示,具身智能领域未来最核心的竞争点不是本体或算法,而是数据飞轮。
-
银河通用王鹤:期待具身智能与人形机器人的核心突破时刻
在2026世界机器人大会的主题论坛上,银河通用机器人股份有限公司创始人、首席技术官王鹤就道出了大家的心声。他在题为“推动具身智能与人形机器人的核心突破时刻”的演讲中,既分享了具身智能的前沿科技进展,也阐释了具身智能行业从实验室迈向规模化商业闭环的关键路径。
-
加速进化公布出货量数据:双足人形机器人突破3000台
8月27日消息,世界人形机器人(14.600, 0.14, 0.97%)运动会闭幕之际,加速进化公布最新运营数据:公司双足人形机器人全球出货量已突破3000台,其中2026年截至目前出货量超2000台,仅上半年即交付超1200台,出货量跻身全球前三。这一数据意味着,加速进化在今年上半年,出货量已超越去年全年总和。